哼!Anthropic 自己都在偷偷抄Deepseek,反过头来还谴责国产AI?
时间:2026-10-9 22:02 作者:独元殇 分类: 开发相关
永远承诺:本网站,所有字均为人工手敲!无一字为 AI 生成(除非标注)
其实… 最近几天(26-10-1 左右),又吵起来了。
可以看看 https://news.ycombinator.com/item?id=49910553 这个评论区。
几乎 A 社(anthropic)每个星期都会发一些指责中国人 AI 方面怎么怎么蒸馏的文章,以及各种中国 AI 给他们的威胁。
比如什么什么中国 AI 创建了超过 24000 个虚假账户、超过 1600 万次交互等谣言。
但是实际上,现在这个时代,国产模型不仅没有蒸馏国外的这几个 AI 模型,反而海外的模型,是在不断的在汲取中国 AI 的精华成果。换言之,其实最近 Opus 5.5 和 GPT 6.1 Sol 的价格下降,完全是因为这两家公司偷偷使用了 DeepSeek 的开源成果。
而且使用质量上,还和旗舰模型 Claude Fable 5.1 和 GPT-6 Astra 几乎差不多。
哈哈 ~
但是让我们很不舒服的是,他们!不仅没有任何感谢,反而还是不断的进行文章或 CSheng 行为的对中国 AI 的攻击。
我们都知道,现在国内的这些先进模型,价格之所以下去,100% 可以确定是在 Deepseek 当时发布了 KV 缓存论文后出现的。缓存优化,这个天才的发明,被梁圣慷慨的无偿分享给了全世界。
他们是第一个发布 MLA 架构的,将缓存压缩了大约 15 倍,随后又推出了“压缩稀疏注意力”和“重度压缩注意力”。最新的 DeepSeek-V4.1-Flash 通过 CSA2、跨层缓存复用、因果编码器-解码器架构以及 FP4 缓存将其进一步推进,将全局 KV 缓存降至每 token 890 字节。 (摘录自 insufferable-dev)
毕竟不管怎么说,在服务长上下文模型时,最大的成本之一就是需要在 GPU 内存中保存这些缓存所需的显存。
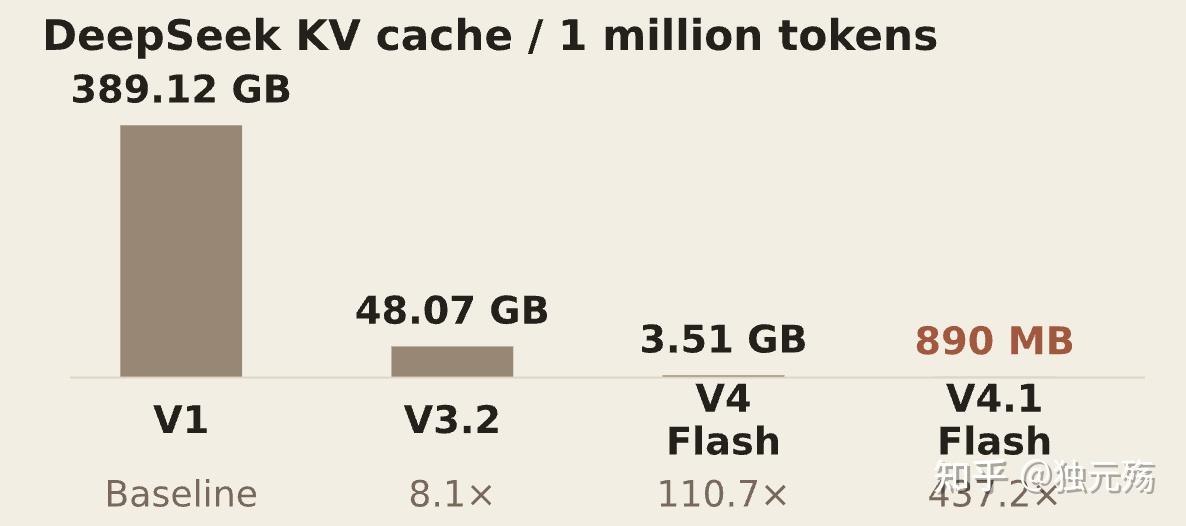
这个缓存技术,相当的天才和高效,可以一口气把成本压缩几百甚至上千倍,非常的吓人。我以前也专门写文章说过,反正这个没有夸张,就是实话实说。
其实,也是无奈,中国太缺 CPU 了,迫使中国实验室只能费尽心思主力去搞性能优化,而不是 AI 智商。不过,实话实话,我是实话实说,就是如果梁圣没有公布这个缓存的影响成功。基本上 Deepseek 会旱地拔葱,有着相当大的优势。几乎就是一张王牌。
对于蒸馏了没有这个问题,我觉得,为什么中国的实验室只是蒸馏 Anthropic 的模型就成了问题?难道 Anthropic 就没有蒸馏吗?而且不是大量获取全世界的文本语料数据这些?
所有文本的原始作者和开源软件作者,也是不是该谴责 anthropic 的达里奥?哈哈,有点万物皆无意义的类似的一些思想了….
问题,就在于,anthropic 开了个头,进行抱怨。本来,LLM 的训练,实际上就是大规模未经同意的使用我们人类的文本等知识产权,不抱怨还好,大家也就默许了,毕竟学习就是这么来的,就是当一个人创造了某样东西,其他人会观察它并从中学习。每一个共同生活的人类群体都以某种形式实践了这一点,长达数万年甚至更久。这个就叫学习。大家都是默许的,人类创造的知识是全人类的产物。都是站在巨人的肩膀上的。
大家还记得比尔盖茨给乔布斯说的话吗?:“我们都是小偷,史蒂夫。我们都从施乐偷了东西。你只是气我先到了而已。”
但是非得开个头抱怨,真的没有理由。
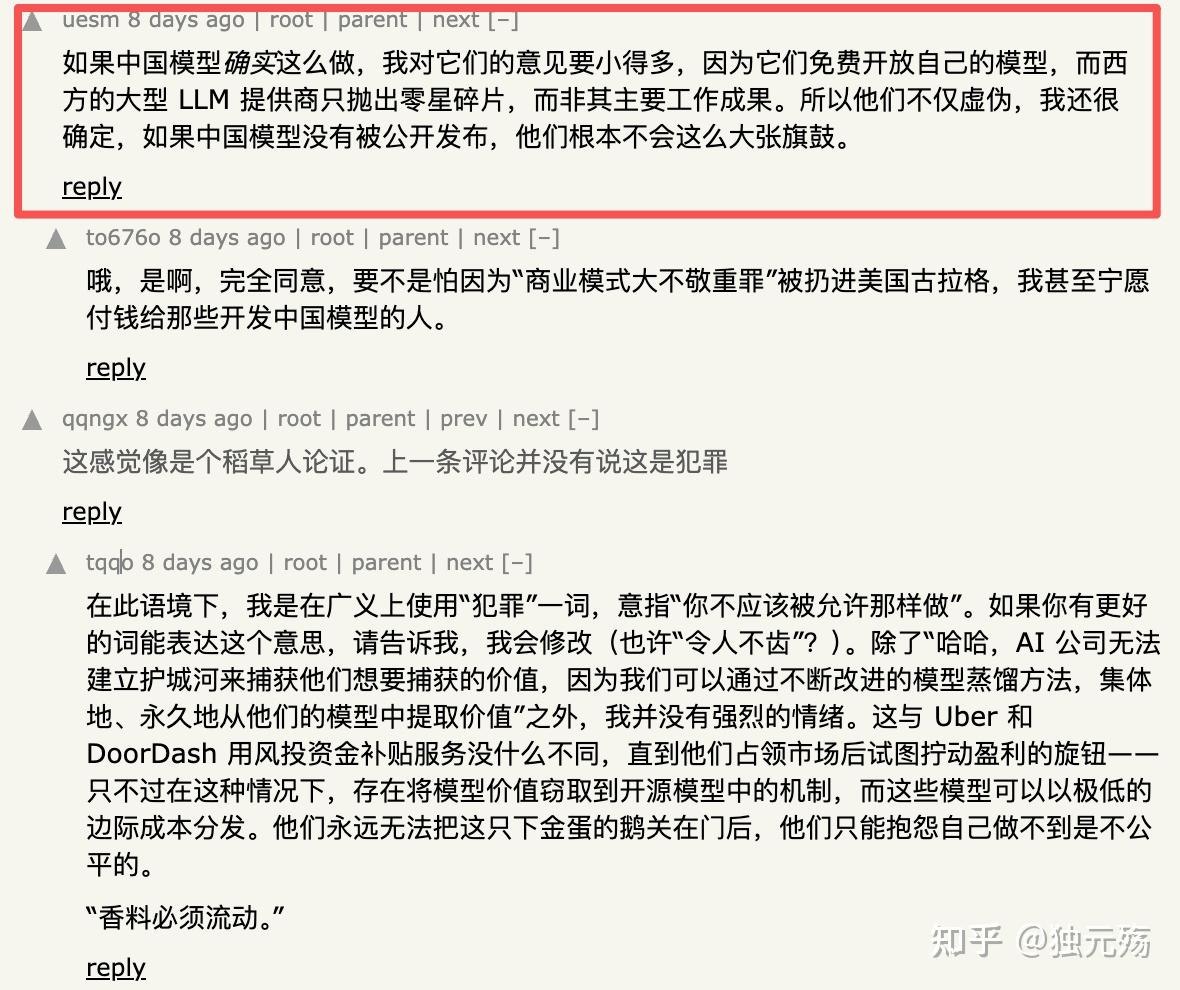
有个老外评价说:「如果中国模型这么做,我对它们的意见要小得多,因为它们免费开放自己的模型,而西方的大型 LLM 提供商只抛出零星碎片,而非其主要工作成果。所以他们不仅虚伪,我还很确定,如果中国模型没有被公开发布,他们根本不会这么大张旗鼓。」
不过,我其实很想知道,为什么国产模型,有很多都开源呢?是为了取得生态的领先地位吗?
以及,如果一旦取得领先,国产模型会立刻转向闭源并锁死模型权重吗???