请多使用国产模型,别痴迷海外模型
时间:2026-9-30 23:21 作者:独元殇 分类: 开发相关
永远承诺:本网站,所有字均为人工手敲!无一字为 AI 生成(除非标注)
其实现在(2026.9.30)基本上可以主力使用国产模型了。
不觉得气人吗?Codex 一天比一天慢,现在也学反重力,玩掺水了。而 Claude 又天天费尽心思封 Chinese 。别痴迷海外这些了,国产模型虽然价格并不便宜多少,但是劲儿很大!!!量也基本管饱。Deepseek 和 GLM 在这方面简直又快又干净。
别天天听那短视频里天天散播焦虑说,说什么一定要想尽办法用上最先进的模型。一年前我认,但是说实话,虽然近半年模型发展的非常的厉害了,但是也只是后训练来劲,在核心能力上,基本已经到瓶颈了,与其跟追星一样去用最先进的模型,还不如把现在的这些小模型给用好。
豆包和 workbuddy 也完全足够了。kimi 审美是一绝(kimi 其实很适合炒股。因为 kimi 有同花顺和天眼查数据库)。
而且干一些道德感低的事的时候,glm5.3flash 和 qwen3.8flash 道德感真的低,不会宕机。
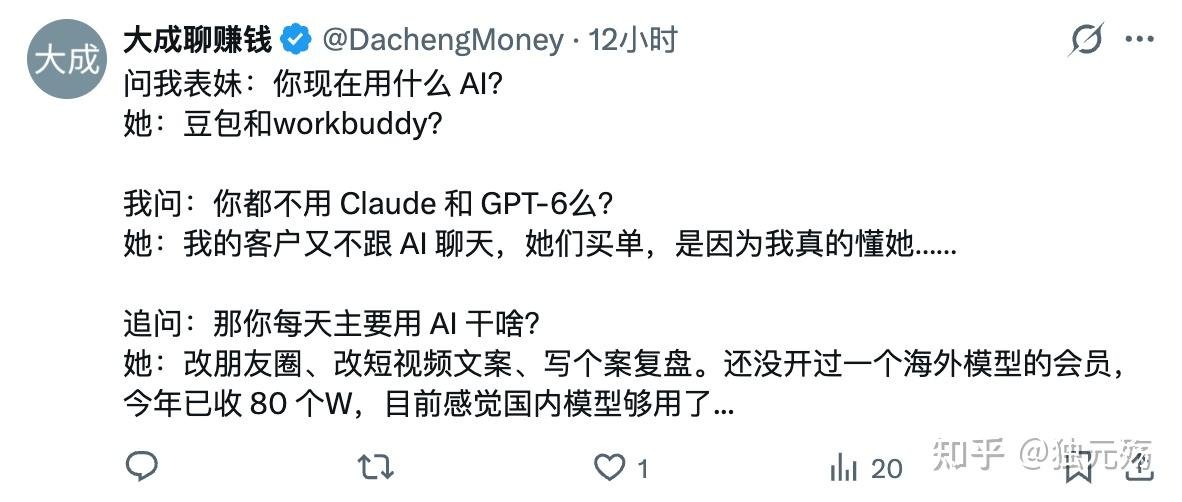
我在推特上看过一个大佬,说她表妹今年 2026 年已经营收 80 万了,她是不使用 Claude 和 GPT-6 的,它就用 豆包 和 WorkBuddy ,能力并不差,就改朋友圈、改短视频文案、写个案复盘。
其实你可以试试,在 workbuddy 里面用 DeepSeekv4.1 输出的文章,比 codex 用 gpt6 出的效果好很多。
对于大部分需要 AI 编程或者办事的人,遇到的事情都没有那么复杂,国产的模型都能解决。(除非你就是研究 AI 的)。现实里绝大多数搬砖和写写自动化脚本的活,能跑通就行,根本不需要天天拉着顶级模型在那搞屠龙之技。
就算编程里,写个嵌入式什么的,全都是简单的代码,全程都在调用 API 什么的,不吃模型的代码能力的,根本不需要很强的 AI (嵌入式 C++ 和 Python 自动化测试这种强逻辑、边界清晰、语料沉淀几十年的垂直场景,很简单的,嵌入式都是有明确验收标准、有偏差可以及时发现的场景,大参数模型更擅长的是处理复杂度和不确定性,用不上)。大部分业务系统并不复杂,就像大部分饭馆都是拉面、盖饭一样。
我一个高中同学是文科办公的,用 GLM5.3 完全能满足文件编写、沉淀 skill 之类的所有需求。合适的才是最好的。
而且你要知道,问题能不能得到解决,并不是选择哪个 AI 就能办到的,目标是解决问题。
现在古法编程,已经被完整淘汰了,只要你有点底阿妈水平,能看懂一点点语法,那么用豆包也能去编程了。
一个合格的程序员,使用 Deepseek ,效率是远远高于一个入门者,使用 Claude Opus 5.5 的。瓶颈根本不在模型上,而是在你自己懂多少上(还有一个关键的指标,就是上下文)。你啥也不懂,给你奥特曼的 Astra 你也是瞎子一个,啥也干不了。这能力和熟练度有关,对底层原理越熟悉越不挑工具。
真程序员去 AI 编程,实际上也只不过让超级智商的旗舰模型给出任务的代码规划和约束,然后让小模型去干活儿。
真的,因为长达一年的相互蒸(xue)馏(xi),现在 AI 的 Coding 能力都大差不差了,现在主要就看个人对编程语言的了解和对 AI 的驾驭能力了。实际工作中,各大 AI 模型的差距真没有多大,Deepseek flash 就能覆盖 98% 的场景了 。
哈哈,回过头来,场景还是那么的似曾相识,历历在目。一两年前,还天天在网上给人争论 PHP 是不是最好的语言,go 多么帅,RUST 多么的快,Java 和 C# 哪个好,Nodejs 多么拉.... 现在没人说这个了,现在都开始争论哪个 AI 好了。